
昨天留下了 LOCAL 的第一條驗收規格:工具逾時、後端結果未知時,不宣稱完成。今天把它變成可重現的 Python 實驗:先讓 SQLite 真正保存請求,再刻意讓成功回覆遺失,檢查系統是否保持待核對、使用原識別碼查回結果,並避免重試產生第二筆。我使用 Antigravity GUI 協助審查、執行與核對,本次本機紀錄顯示 20 項測試通過。這是離線工具契約的驗證,尚未呼叫 Gemini、LINE 或雲端,也不代表整套 Agent 已可靠。
This chapter turns LOCAL’s Day 1 acceptance specification into a reproducible, offline experiment. A real SQLite write is followed by an intentionally lost response. We check that the caller keeps the outcome pending, reconciles it using the original operation key, and does not create a duplicate on retry. I used the Antigravity GUI to assist with review and execution. The local run passed 20 tests using Python 3.13.5 and SQLite 3.49.1 on macOS. These results apply only to the tested cases, not to overall agent reliability. No Gemini, LINE, or cloud calls were made.
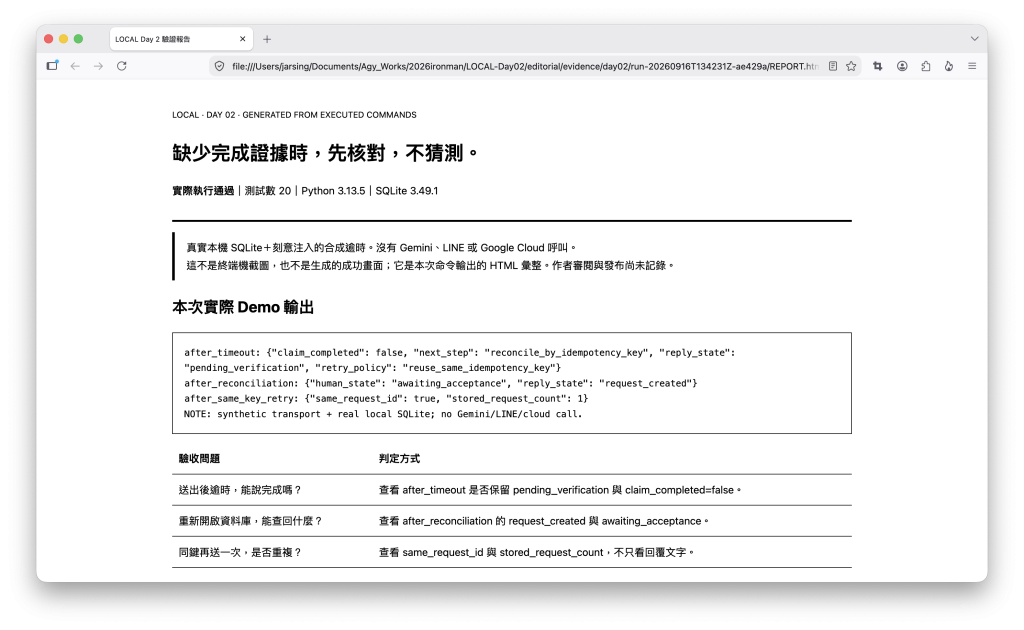
圖1:LOCAL Day 2 本機驗證報告。20 項測試通過;合成逾時後先保持待核對,查回 SQLite 紀錄後確認請求已建立、仍等待真人受理;同一操作重試取得相同請求識別碼,資料庫維持一筆。本次未呼叫 Gemini、LINE 或雲端服務。
| 先分開三個觀察 | 本篇的判定 |
|---|---|
| 送出端只看到逾時 | 暫時不知道後端有沒有完成,不猜測 |
| 後端查到請求紀錄 | 證明請求已建立,不代表真人已受理 |
| 同一操作重試 | 沿用同一識別碼,不建立第二筆 |
地方服務的對話,不能只看最後一句話是不是親切。
用一個合成情境來看:使用者正在詢問社區走讀活動,想請真人協助確認無障礙需求。系統顯示操作內容,使用者同意後,準備建立一筆協助請求。
如果這時工具回報 timeout,我們能不能告訴他「已經幫你安排好了」?
先看兩個可能的世界:
| 故障發生位置 | 送出端看到的結果 | 實驗中的資料庫 |
|---|---|---|
| 寫入之前 | timeout |
沒有請求 |
| 已提交寫入,但成功回覆遺失 | timeout |
已有一筆請求 |
送出端看到的字一樣,後端事實卻不同。單靠這個 timeout,既不能證明成功,也不能證明失敗。
如果直接換個新識別碼重送,還可能把同一件事做兩次。這不是靠「提示詞寫得更兇」就能解決的問題:模型沒有得到的證據,應用程式不能要求它用自信補上。
LOCAL 後面會接上 Gemini、ADK 與 LINE;今天先把這個工具邊界釘清楚。先定義怎麼驗收,再請 AI 協助實作,是這篇真正要做的事。
本篇把 test harness 當作工作用語,指讓規格、輸入、可控制的故障、實際執行與判定能一起重跑的小環境。它不是另一個模型,也不是加一個套件就自動擁有的可靠性。
今天的範圍很小:
原始規格 → 合成請求 → 真實 SQLite 寫入 → 注入逾時 → 查回後端 → 驗收。
這份實驗的執行條件是 Python 3.10 以上,以及可用的 sqlite3 模組。範例使用標準函式庫,不需要安裝模型 SDK、不需要 API 金鑰,也不需要申請雲端主機。Python 官方說明,SQLite 是不需要獨立伺服器程序的輕量磁碟資料庫,適合作為今天的可重現起點。[2]
另外,程式使用的 UPSERT 語法需要 SQLite 3.24.0 以上;驗證腳本會檢查這個條件。本次實際使用的版本是 Python 3.13.5 與 SQLite 3.49.1,環境與結果放在第七節一起核對。[3]
這是一個測試環境,不是完整的 Agent runtime harness。未來的工具權限、有效確認、呼叫次數、模型上下文與服務編排,還要逐步接上。
原本的 docs/day01/handoff-timeout-001.json 有以下 expected 內容:[1]
{
  "reply_state": "pending_verification",
  "claim_completed": false,
  "next_step": "reconcile_by_idempotency_key",
  "retry_policy": "reuse_same_idempotency_key"
}
這是 LOCAL 自訂的合成驗收規格,不是 LINE 或 Google 的官方 API payload。
它要求四件事:狀態保持待核對、不宣稱完成、用原操作識別碼查回結果,以及重試仍沿用原識別碼。測試同時核對原檔的 Git blob 識別,避免不小心改了首篇的驗收依據。
實作的政策函式獨立寫在程式裡。以下節錄核心內容,省略型別註記:
def pending_verification():
    return {
        "reply_state": "pending_verification",
        "claim_completed": False,
        "next_step": "reconcile_by_idempotency_key",
        "retry_policy": "reuse_same_idempotency_key",
    }
為什麼不直接讀 JSON,把 expected 原封不動回傳?因為那會讓實作與測試共用同一份答案,即使政策設計有問題,測試也可能只是在證明自己和自己相同。
不過,把兩者分開也不是完整證明。測試仍可能有共同盲點,因此還需要反例、後端狀態,以及後續真正的模型與工具整合。
今天的關鍵片段是:
receipt = store.create(request)  # 返回前,資料庫交易已提交
if fault is Fault.AFTER_COMMIT:
    raise TimeoutError("SYNTHETIC: reply lost after committed write")
return verified_receipt(receipt)
SQLite 真的保存合成的服務識別、請求文字、內容雜湊與回執;TimeoutError 則是我們刻意在提交後注入的故障。這不是在聲稱 Google 或 LINE 曾經發生這次錯誤。
在本範例的連線設定下,程式以連線的 context manager 管理已開啟的交易,離開區塊並成功提交後,才回傳回執。Python 官方也提醒,連線 context manager 不會自行開啟交易或關閉連線;有待處理交易時,才依執行結果提交或回復,因此範例另用 finally 關閉連線。[2]
送出端捕捉到注入的逾時後,只能回到待核對。它不根據「通常應該成功」來推論,也不把所有資料庫例外都包裝成相同的逾時。
本篇以這三個值界定操作:
tenant_id + user_id + idempotency_key
它們在本篇都是可信的合成夾具,不是從模型自由生成的身分,也不是完整的正式授權機制。
資料表使用三者的複合唯一鍵。在同一交易內嘗試寫入,再查回紀錄:
INSERT INTO requests (
  tenant_id, user_id, idempotency_key, payload_hash,
  service_id, request_text, request_id, human_state
)
VALUES (?, ?, ?, ?, ?, ?, ?, ?)
ON CONFLICT (tenant_id, user_id, idempotency_key) DO NOTHING;
SQLite 的 UPSERT 可以在指定唯一性衝突時選擇不插入;但「不插入」本身不代表這次操作合理,我們還要核對既有紀錄。[3]
因此,查回之後還會比較請求內容的 SHA-256 雜湊。同一識別碼、同一內容,回到原回執;同一識別碼、不同內容,明確回報衝突。 不能偷偷修改請求文字,卻把上一筆的成功回執當成新內容已送出的證明。
這裡的 SHA-256 用來比較內容,不是授權憑證,更不能因為做了雜湊就稱資料已匿名。
也不要把這個實驗稱為分散式系統的「精確一次」保證。今天只驗證這個本機資料庫交易邊界內的一種寫入;日後接外部系統,必須重新確認對方的冪等與查詢契約。
這份實驗的候選程式與文章透過 AI 協作整理。這次我使用 Antigravity GUI 協助審查、執行與核對本機實驗;文章採用的是這次執行留下的紀錄,不是先前助手環境的測試結果。
要重現這段協作,關鍵不是複製一份「Agent 已完成」的說明,而是讓它清楚知道讀取範圍、檢查對象與應交付的證據。
依 Antigravity 2.0 官方指南,可以建立 Project、加入本機資料夾或 Repo,以 Local Mode 開始工作;Implementation Plan 則提供使用者審閱計畫與留下批註的方式。[4][5]
給 Agent 的任務可以很直接:
先讀 Day 1 的驗收 JSON 與 examples/day02/README.md。
先說明今天要驗證哪個主張,再執行本機測試。
不修改 Day 1、不放寬測試預期、不跳過失敗案例。
不要呼叫 Google/LINE API,不要 commit、push 或部署。
交付實際命令、退出碼、輸出與尚未驗證的限制。
我關心的不只是它說「測試通過」,而是四個問題:
它跑的是哪份檔案?資料庫真的寫了什麼?遇到不確定狀態時回覆了什麼?重試後是不是同一筆?
圖形介面的價值,在於能把計畫、檔案差異和執行結果放在一起檢查。命令仍是重現的方法;只是讀者不需要先把背熟命令當成入門門檻。
這次作者本機的 verification.json、CHATGPT_HANDOFF.md 與 REPORT.html,記錄了相同的版本、測試數與 Demo 結果:
| 核對項目 | 本次紀錄 |
|---|---|
| 作業系統 | macOS,報告中的平台值為 Darwin |
| Python | 3.13.5 |
| SQLite | 3.49.1 |
| 測試結果 | 20 項測試通過,unittest 退出碼為 0 |
| Demo 結果 | 退出碼為 0 |
| 報告產生時間 | 2026/09/16 21:42:31(臺灣時間,UTC+8;原始 UTC 為 13:42:31) |
| 執行範圍 | 合成故障+真實本機 SQLite;沒有 Gemini、LINE 或雲端呼叫 |
報告記錄的兩個執行命令如下,工作目錄是 Repo 根目錄:
python -m unittest discover -s examples/day02 -p test_demo.py -v
python examples/day02/demo.py
python 是驗證報告顯示的命令名稱;verify.py 實際以啟動它的同一個 Python 直譯器執行子命令。自行重跑時,請使用已確認符合版本條件的直譯器,不要只看命令叫 python 還是 python3。
本次單元測試輸出為:
Ran 20 tests in 0.050s

OK
這裡的 0.050s 只是這一次單元測試的總執行時間,不是 Agent 回應時間、模型延遲或服務效能承諾。
20 項測試檢查的不只是順利送出的情境:
| 案例群 | 測試數 | 本次通過的檢查範圍 |
|---|---|---|
| 原始規格與政策 | 2 | Day 1 檔案識別不變,逾時回覆符合既有預期 |
| 真實保存與回執內容 | 2 | 服務與請求文字確實保存;對使用者的回執不附帶請求文字、使用者識別或內容雜湊 |
| 故障位置與核對失敗 | 4 | 寫入前/提交後逾時、查不到回執、核對不可用時的處理 |
| 確認與輸入檢查 | 5 | 未確認、字串 "true"、空識別碼、錯誤故障參數與非字串欄位 |
| 冪等與內容衝突 | 3 | 同鍵重試回到原回執;改過內容不能沿用既有成功結果 |
| 重新開啟資料庫 | 1 | 新連線仍能查回同一份檔案中的請求 |
| 合成身分範圍 | 2 | 另一位合成使用者或場域,查不到原範圍的請求 |
| 小規模並發 | 1 | 4 個工作執行緒提交 8 次同鍵請求,檢查仍為一筆與同一回執 |
這張表是在整理同一套測試,不是另外多跑了八組實驗,也不是正式授權或壓力測試的完成證明。
Demo 的本次實際輸出如下:
after_timeout: {"claim_completed": false, "next_step": "reconcile_by_idempotency_key", "reply_state": "pending_verification", "retry_policy": "reuse_same_idempotency_key"}
after_reconciliation: {"human_state": "awaiting_acceptance", "reply_state": "request_created"}
after_same_key_retry: {"same_request_id": true, "stored_request_count": 1}
NOTE: synthetic transport + real local SQLite; no Gemini/LINE/cloud call.
第一段:送出端不知道結果,所以不宣稱完成。
第二段:關閉原連線後重新開啟同一份資料庫,用原操作識別碼查到請求。這不是只查一個 Python 變數。
第三段:同一操作重試,得到同一個回執,而且仍只有一筆。
verify.py 會執行測試與 Demo,留下命令、退出碼、Python/SQLite 版本、來源檔案 SHA-256,以及可在瀏覽器開啟的 REPORT.html。它不呼叫 Git、不推送檔案;輸出位置由操作者指定。SHA-256 用來核對檔案內容,不能代替尚未確認的公開 commit。
HTML 報告是實際輸出的彙整,不是終端機截圖,也不是製作一張看起來成功的圖片。原始紀錄仍要保留。若測試失敗或沒有找到測試,就不能把報告當成通過。
同樣地,overall: PASS 只表示腳本的檢查通過。這份執行快照保留 author_review: not_recorded、published: false,因為腳本不負責查核作者審閱或發布狀態;後續的人工審閱、程式公開與 iThome 發表,要另外記錄,不能由測試結果自動代簽。
本篇的狀態有意保持精確:
請求已建立 → 等待真人受理 → 真人已受理 → 服務完成。
今天只做到請求建立並等待受理,沒有實作真人受理與服務完成的流程;因此回傳 human_state: awaiting_acceptance。它不能證明真人已讀過,更不能證明走讀活動已安排好無障礙措施。
這也是未來 LINE 介面必須處理的事情:不是把 request_created 美化成「都幫你處理好了」,而是讓使用者理解目前進度與下一步。
反過來說,核對時查不到也不要立即宣布沒有寫入。在今天的合成實驗裡,我們知道注入點;在真正的遠端系統,原操作可能還在進行。是否等待、何時重試、何時轉人工,都需要進一步的服務契約。
本篇驗證的是一種可重現的工具結果邊界:未知時先核對、沿用操作識別碼、以資料庫證據決定回覆。
它沒有驗證 Gemini 的回答品質、工具選擇正確率、LINE 驗簽、Firestore 交易、雲端重啟或正式真人受理。confirmed 仍是測試用布林值;真實身分、操作內容與有效期限要在後續篇章綁定。
資料庫重新開啟不等於完整的程序崩潰或斷電復原測試;4 個工作執行緒處理 8 次同鍵提交,也不是大規模壓力測試。Demo 使用暫存目錄裡的實體 SQLite 檔案,結束後會清理;本篇驗證的是示範期間跨連線能查回資料,不是已經建立永久營運資料庫。
所有資料都是合成的,沒有正式使用者資料、Gemini 模型用量或由本實驗產生的雲端呼叫費用;這不等於評估了 Antigravity 開發工具本身的使用量。
20 個測試是二十個已定義案例的檢查,不是整套 Agent 永不犯錯的保證。
下一篇會從 Google AI Studio 與 Gemini API 建立第一個可重現的模型實驗,記錄使用的模型、SDK、輸入、輸出與設定。當模型開始整理資訊、提出工具請求,我們就能分別檢查它怎麼理解、提出什麼操作,以及後端真的發生什麼。
今天沒有先追求一個什麼都能做的 Agent,而是留下了一條以後不能輕易放寬的標準:
缺少完成的證據時,先核對,不猜測。
examples/day02/,重現說明安排於 docs/day02/;公開版本以實際發布的內容為準。重現時請記錄對應 commit,不要拿舊測試結果替新程式背書。本篇實測數據依據本次 verification.json、CHATGPT_HANDOFF.md 與 REPORT.html;官方產品說明依上述文件核對。官方文件查證日期:2026/09/16。
前篇:Day 1|LOCAL:把地方服務需求變成 LINE × Google AI 的工程規格。


 iThome鐵人賽
 看影片追技術